00
前期准备
练习材料
下载材料包| 材料 | 用途 | 文件 |
|---|---|---|
| 招聘计划与系统导出 | 对照需求状态、排期和阶段记录 | 招聘计划.xlsx / 招聘系统导出_20261016.csv |
| 流程规则 | 本例时限、公司日历与身份口径 | 招聘流程规则.pdf |
| 邮件与审批截图 | 核对反馈、改期、接受及审批状态 | 回执邮件/ / 审批截图/ |
| 核对脚本与口径 | 复算人数、工作日和可机械判断的记录差异 | scripts/ |
查看练习材料19份材料
系统导出(13条申请)招聘系统导出_20261016.csv
| 申请编号 | 候选人 | 手机号 | 招聘需求编号 | 当前阶段 | 阶段进入日期 | 面试时间 | 反馈完成时间 | Offer审批时间 | 最后更新 |
|---|---|---|---|---|---|---|---|---|---|
| APP-101-01 | 候选人01 | TEL-01 | REQ-101 | 二面 | 2026-10-12 | 2026-10-13 14:00 | 2026-10-14 10:20 | 2026-10-14 10:21 | |
| APP-101-02 | 候选人02 | TEL-02 | REQ-101 | 一面 | 2026-10-08 | 2026-10-09 10:00 | 2026-10-09 11:02 | ||
| APP-101-03 | 候选人03 | TEL-03 | REQ-101 | 二面 | 2026-10-09 | 2026-10-12 15:00 | 2026-10-12 16:30 | ||
| APP-101-04 | 候选人04 | TEL-04 | REQ-101 | Offer审批 | 2026-10-13 | 2026-10-12 17:40 | 2026-10-13 09:15 | ||
| APP-101-05 | 候选人05 | TEL-05 | REQ-101 | Offer审批 | 2026-10-12 | 2026-10-10 18:00 | 2026-10-15 14:20 | 2026-10-15 14:20 | |
| APP-102-01 | 候选人06 | TEL-06 | REQ-102 | 用人经理复核 | 2026-10-14 | 2026-10-13 16:00 | 2026-10-14 09:30 | 2026-10-14 09:31 | |
| APP-102-02 | 候选人07 | TEL-07 | REQ-102 | 一面 | 2026-10-09 | 2026-10-09 17:00 | |||
| APP-102-03 | 候选人08 | TEL-08 | REQ-102 | Offer已接受 | 2026-10-15 | 2026-10-09 12:00 | 2026-10-13 11:00 | 2026-10-15 20:05 | |
| APP-103-01 | 候选人09 | TEL-09 | REQ-103 | 一面 | 2026-10-13 | 2026-10-14 10:00 | 2026-10-13 10:00 | ||
| APP-104-01 | 候选人10 | TEL-10 | REQ-104 | 简历筛选 | 2026-10-12 | 2026-10-12 09:00 | |||
| APP-104-02 | 候选人11 | TEL-11 | REQ-104 | 一面 | 2026-10-13 | 2026-10-15 11:00 | 2026-10-13 15:00 | ||
| APP-104-03 | 候选人12 | TEL-12 | REQ-104 | 二面 | 2026-10-14 | 2026-10-15 16:00 | 2026-10-16 09:10 | 2026-10-16 09:11 | |
| APP-104-05 | 候选人11 | TEL-11 | REQ-104 | 一面 | 2026-10-14 | 2026-10-15 11:00 | 2026-10-14 08:40 |
招聘计划(需求与排期双表)招聘计划.xlsx
打开完整预览可切换“需求计划”和“面试排期”,并下载同版Excel文件。
招聘流程规则.pdf招聘流程规则.pdf
澄川科技 招聘流程规则 v1.2
生效:2026-09-01 适用:社会招聘全部岗位。【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,
不对应任何真实个人。


1. 统计口径
进度检查以系统导出日为统计日。工作日按公司日历计:2026-10-01 至 10-07 国庆休息;2026-10-10
(周六)调休上班,计为工作日;其余周六、周日不计。进入阶段(或面试)当天不计,统计日当天计入。
(本日历为教学虚构。)


2. 各阶段时限
   阶段               计时起点      时限(工作日) 超时处理

简历筛选       阶段进入日期            2         标记卡住

一面 / 二面    面试时间;未排期时为阶段进入日期 反馈 2;未排期 3 标记卡住

用人经理复核 阶段进入日期                3         标记卡住

Offer 审批   阶段进入日期            2         标记卡住


3. 回执
面试反馈以面试官邮件或系统录入为准;自动回复(含休假自动回复)不视为反馈。Offer 审批以审批系
统状态为准;审批通过后系统阶段应在 1 个工作日内更新。


4. 需求状态
需求“暂停”期间不得新安排面试;已在办申请需招聘负责人书面确认是否继续。


5. 主键
同一手机号出现多条申请视为重复申请,统计时按一人计,由 HR 合并。
01_二面反馈_APP-101-01回执邮件/01_二面反馈_APP-101-01.eml
发件人:高远 <gaoyuan@chengchuan.example>
时间:2026-10-14T10:18:00+08:00
主题:【面试反馈】APP-101-01 候选人01 二面

周敏你好,
候选人01(APP-101-01,候选人电话 TEL-01)二面已完成,反馈已录系统,结论:建议进入用人经理复核。
高远

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
02_一面反馈_HTML_APP-101-02回执邮件/02_一面反馈_HTML_APP-101-02.eml
发件人:唐宁 <tangning@chengchuan.example>
时间:2026-10-12T19:42:00+08:00
主题:Re: 【请反馈】APP-101-02 候选人02 一面


周敏:

补发一面反馈,系统那边我还没来得及录。


申请编号

APP-101-02


候选人

候选人02(TEL-02)


面试时间

2026-10-09 10:00


结论

通过,建议二面


唐宁

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
03_催反馈_APP-101-03回执邮件/03_催反馈_APP-101-03.eml
发件人:周敏 <zhoumin@chengchuan.example>
时间:2026-10-13T09:05:00+08:00
主题:【请反馈】APP-101-03 候选人03 二面(10-12 已面)

高远你好,候选人03(APP-101-03)10-12 15:00 二面已结束,系统里还没有反馈,麻烦今天录一下。
周敏

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
04_自动回复_APP-101-03回执邮件/04_自动回复_APP-101-03.eml
发件人:高远 <gaoyuan@chengchuan.example>
时间:2026-10-13T09:05:00+08:00
主题:自动回复: 【请反馈】APP-101-03 候选人03 二面(10-12 已面)

您好,我 10 月 13 日至 10 月 20 日休假,期间不查看邮件。紧急事务请联系 唐宁。
——此为自动回复

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
05_转发链_改期_APP-102-02回执邮件/05_转发链_改期_APP-102-02.eml
发件人:王蕾 <wanglei@xingqiao-hunter.example>
时间:2026-10-15T08:47:00+08:00
主题:Fwd: Fwd: 关于 10 月 15 日一面时间(APP-102-02)

周敏,候选人要改期,转你处理,系统里还是原来的状态。
——王蕾(星桥猎头)

-------- 转发的邮件 --------
发件人: 王蕾 <wanglei@xingqiao-hunter.example>
日期: 2026年10月14日 18:20
收件人: 贺川 <hechuan@chengchuan.example>
主题: Fwd: 关于 10 月 15 日一面时间

贺老师,候选人07想改期,原邮件见下。

-------- 转发的邮件 --------
发件人: 候选人07 <cand01@masked.example>
日期: 2026年10月14日 17:55
收件人: 王蕾 <wanglei@xingqiao-hunter.example>
主题: 关于 10 月 15 日一面时间

王老师您好,10 月 15 日我临时有事,能否改到 10 月 19 日(周一)下午?我的电话 TEL-07。
候选人07

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
06_二面反馈_APP-104-03回执邮件/06_二面反馈_APP-104-03.eml
发件人:吴桐 <wutong@chengchuan.example>
时间:2026-10-16T09:08:00+08:00
主题:【面试反馈】APP-104-03 候选人12 二面

刘畅:候选人12(APP-104-03)二面反馈已录系统,建议进入用人经理复核。
吴桐

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
07_候选人确认_APP-101-06回执邮件/07_候选人确认_APP-101-06.eml
发件人:候选人13 <cand02@masked.example>
时间:2026-10-14T21:10:00+08:00
主题:Re: 澄川科技 后端工程师 一面邀请(10月16日 14:00)

周老师您好,确认 10 月 16 日 14:00 参加一面,申请编号是 APP-101-06。我的电话 TEL-13。
候选人13

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
08_Offer接受_APP-102-03回执邮件/08_Offer接受_APP-102-03.eml
发件人:候选人08 <cand03@masked.example>
时间:2026-10-15T20:03:00+08:00
主题:Re: 澄川科技 Offer 通知

周老师,我接受 Offer,预计 11 月 2 日入职。候选人08 TEL-08

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
09_一面反馈_APP-103-01回执邮件/09_一面反馈_APP-103-01.eml
发件人:马骁 <maxiao@chengchuan.example>
时间:2026-10-14T12:30:00+08:00
主题:【面试反馈】APP-103-01 候选人09 一面

刘畅:候选人09一面已面完,需求不是暂停了吗?反馈先发邮件,系统我先不录,你确认一下是否继续。
马骁

【教学虚构样例】本文件中的人员、电话、邮箱均为虚构,不对应任何真实个人。
审批_APP-101-04审批截图/审批_APP-101-04.png
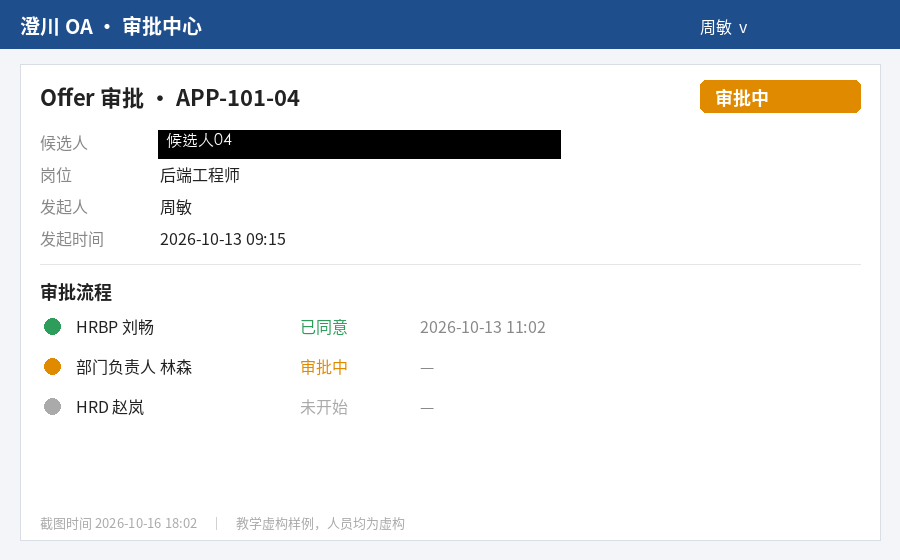
本机Apple Vision OCR实际提取;非人工批准,识别字可能有误,关键字段回图片核对。
原图:审批_APP-101-04.png
SHA256:d2c08f0ac5fb37800476924586b87ab8659046fa091806efcb47b5a44976d6e1

澄川 OA •审批中心
周敏v
Offer 审批。APP-101-04
审批中
候选人
候选人04
岗位
后端工程师
发起人
周敏
发起时间
2026-10-13 09:15
审批流程
• HRBP刘畅
已同意
2026-10-13 11:02
•部门负责人林森
审批中
● HRD赵岚
未开始
截图时间 2026-10-16 18:02 |教学虚构样例,人员均为虚构
审批_APP-101-05审批截图/审批_APP-101-05.png
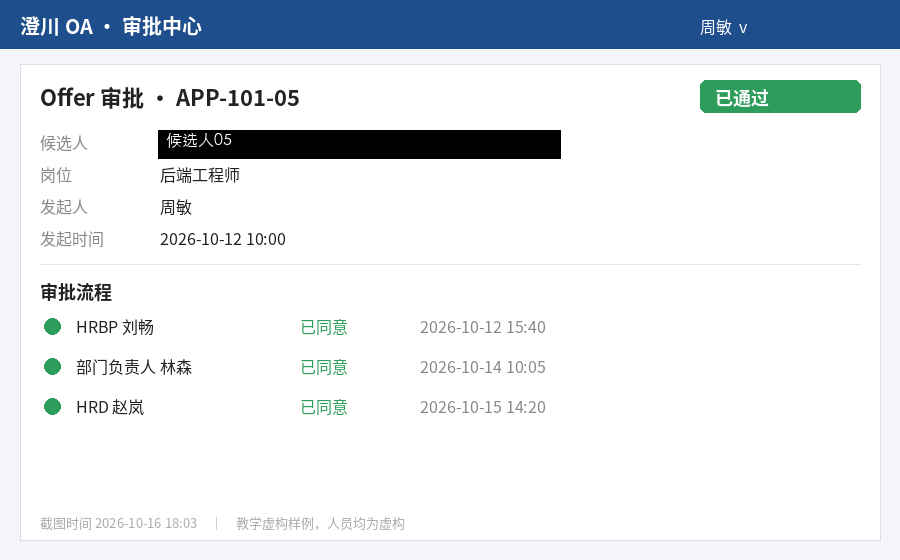
本机Apple Vision OCR实际提取;非人工批准,识别字可能有误,关键字段回图片核对。
原图:审批_APP-101-05.png
SHA256:006dcc5e33a83236a1ba4b1421a9d0c1a0879990c80def94871f1628b5a13cb7

澄川 OA 。审批中心
周敏v
Offer审批・APP-101-05
已通过
候选人
候选人05
岗位
后端工程师
发起人
周敏
发起时间
2026-10-12 10:00
审批流程
•HRBP刘畅
已同意
2026-10-12 15:40
•部门负责人 林森
已同意
2026-10-14 10:05
HRD赵岚
已同意
2026-10-15 14:20
截图时间 2026-10-16 18:03 |教学虚构样例,人员均为虚构
审批_APP-102-03审批截图/审批_APP-102-03.png
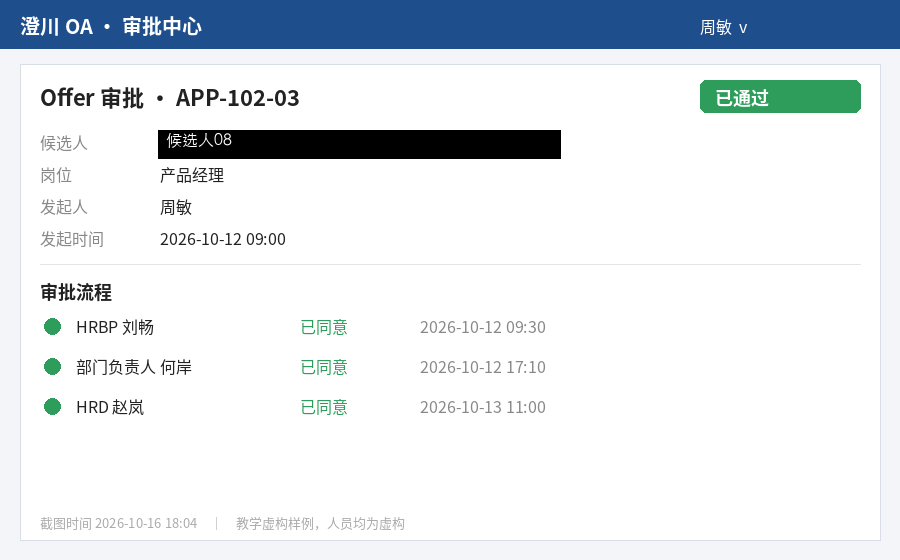
本机Apple Vision OCR实际提取;非人工批准,识别字可能有误,关键字段回图片核对。
原图:审批_APP-102-03.png
SHA256:5e350eb2d6191fb416a1cf6dc8607fd7ade487f43fe4420fb4553c142f032820

澄川 OA 。审批中心
周敏v
Offer审批・APP-102-03
已通过
候选人
候选人08
岗位
产品经理
发起人
周敏
发起时间
2026-10-12 09:00
审批流程
•HRBP 刘畅
已同意
2026-10-12 09:30
●部门负责人 何岸
已同意
2026-10-12 17:10
● HRD赵岚
已同意
2026-10-13 11:00
截图时间 2026-10-16 18:04 |教学虚构样例,人员均为虚构
check_stages.pyscripts/check_stages.py
"""离线机械核对:人数、工作日与记录差异。不会决定处置或写回系统。

python3 scripts/check_stages.py 工作目录 审批字段.csv --rules scripts/核对口径.json --output-dir 核对结果
审批字段列:截图文件,申请编号,截图状态,最后节点时间,当前节点。
审批字段须先与原图核对;本脚本不识图。退出0只表示运算完成,不代表没有业务问题;退出2表示未完成。
"""
import argparse
import csv
import json
import re
import sys
from collections import Counter, defaultdict
from datetime import date, datetime, timedelta
from pathlib import Path
import openpyxl
from identity import group_people, person_key
from read_eml import read_messages

STAGES = ['简历筛选','一面','二面','用人经理复核','Offer审批','Offer已接受']


def parse_date(value):
    if not value: return None
    if isinstance(value, (date, datetime)): return value.date() if isinstance(value, datetime) else value
    return date.fromisoformat(str(value)[:10])


class Calendar:
    def __init__(self, config):
        self.stat = parse_date(config['统计日'])
        self.holidays = {parse_date(x) for x in config['休息日']}
        self.extra = {parse_date(x) for x in config['调休工作日']}
        self.limits = config['时限_工作日']
        if any(not isinstance(n,int) or n < 1 for n in self.limits.values()): raise ValueError('时限必须为正整数')
    def is_workday(self, value):
        return value in self.extra or (value.weekday()<5 and value not in self.holidays)
    def elapsed(self, start, end=None):
        end = end or self.stat; count = 0
        while start < end:
            start += timedelta(days=1)
            count += self.is_workday(start)
        return count
    def due(self, start, days):
        while days:
            start += timedelta(days=1)
            if self.is_workday(start): days -= 1
        return start


def read_rows(work):
    files = list(Path(work).glob('*.csv'))
    files = [f for f in files if f.name.startswith('招聘系统导出')]
    if len(files)!=1: raise ValueError('工作目录须有唯一的招聘系统导出CSV')
    with files[0].open(encoding='utf-8-sig') as f:
        rows = list(csv.DictReader(f))
    if not rows: raise ValueError('系统导出没有数据')
    required = ['申请编号','候选人','手机号','招聘需求编号','当前阶段','阶段进入日期','面试时间','反馈完成时间']
    if any(k not in rows[0] for k in required): raise ValueError('系统导出缺必要列')
    ids = [r['申请编号'] for r in rows]
    if not all(ids) or len(set(ids))!=len(ids): raise ValueError('申请编号为空或同一申请多行,先核对核心身份')
    for i,row in enumerate(rows,2):
        row['_line']=i
        if row['当前阶段'] not in STAGES: raise ValueError('未知阶段:'+row['当前阶段'])
        if not row['阶段进入日期']: raise ValueError('缺阶段进入日期:'+row['申请编号'])
        for k in ['阶段进入日期','面试时间','反馈完成时间']:
            if row[k]: parse_date(row[k])
    return files[0].name,rows


def analyze(work, approval_file, rules):
    work=Path(work); cal=Calendar(rules); csv_name,rows=read_rows(work); by_id={r['申请编号']:r for r in rows}
    wb=openpyxl.load_workbook(work/'招聘计划.xlsx',data_only=True)
    req={r[0].value:{'status':r[4].value,'owner':r[5].value,'line':r[0].row,'note':r[6].value or ''}for r in wb['需求计划'].iter_rows(min_row=5)if r[0].value}
    plan={r[0].value:{'date':r[4].value,'line':r[0].row,'candidate':r[1].value}for r in wb['面试排期'].iter_rows(min_row=5)if r[0].value}
    messages=read_messages(work/'回执邮件'); mails=defaultdict(list); unresolved=[]
    for msg in messages:
        ids=msg['正文编号'] or msg['文件名编号']
        if not ids: unresolved.append(msg['文件']);continue
        for aid in ids:
            # 只有文件名编号时,再用正文完整号码代号交叉核对,避免凭文件名认人。
            known=bool(msg['正文编号']) or (aid in by_id and by_id[aid]['手机号'] in msg['号码代号'])
            if known: mails[aid].append(msg)
            else: unresolved.append(msg['文件']+'(编号归属待核)')
    approvals={}
    if approval_file:
        with Path(approval_file).open(encoding='utf-8-sig') as f:
            for row in csv.DictReader(f):
                if not all(k in row for k in ['截图文件','申请编号','截图状态','最后节点时间','当前节点']): raise ValueError('审批字段CSV列名不完整')
                aid=row['申请编号']
                if aid in approvals: raise ValueError('审批字段有重复申请编号:'+aid)
                if row['截图状态'] not in ['已通过','审批中']: raise ValueError('无法识别审批状态:'+aid)
                parse_date(row['最后节点时间']);approvals[aid]=row
    groups=group_people(rows); raw=Counter(r['当前阶段']for r in rows);counts=Counter();multi=[];unknown=[]
    for key,rs in groups.items():
        stages={r['当前阶段']for r in rs}
        if key.startswith('待核:'):unknown.append([r['申请编号']for r in rs])
        if len(stages)==1: counts[next(iter(stages))]+=1
        else:counts['多阶段待确认']+=1;multi.append([r['申请编号']for r in rs])
    findings=[]
    def add(aid,kind,detail,sources,key=None):
        identity=key or person_key(by_id[aid])
        findings.append({'申请编号':aid,'候选身份':identity,'类型':kind,'事项':detail,'来源':'; '.join(sources)})
    for row in rows:
        aid=row['申请编号'];stage=row['当前阶段'];src=f'{csv_name} 第{row["_line"]}行';enter=parse_date(row['阶段进入日期']);ms=mails[aid]
        request=req.get(row['招聘需求编号'])
        if request and request['status']=='暂停' and stage!='Offer已接受':
            add(aid,'待确认','需求暂停;是否已有负责人继续办理的书面确认须回原文核实,不从面试发生日推断安排创建日',[src,f'招聘计划.xlsx[需求计划]第{request["line"]}行'])
        if stage in ['一面','二面']:
            iv=parse_date(row['面试时间']);fb=parse_date(row['反馈完成时间']);fb_mail=[m for m in ms if m['类型']in ['反馈已录','反馈未录']];unknown_mail=[m for m in ms if m['类型'].startswith('未识别')]
            if iv:
                dates=([fb]if fb else[])+[parse_date(m['时间'])for m in fb_mail]
                if dates:
                    effective=min(dates)
                    if not fb and fb_mail:add(aid,'记录待同步','系统反馈时间为空,面试官邮件已有反馈;不能算作无反馈',[src,*['回执邮件/'+m['文件']for m in fb_mail]])
                    if cal.elapsed(iv,effective)>cal.limits['面试反馈']:add(aid,'历史超时待核',f'最早已知反馈距面试超过{cal.limits["面试反馈"]}个工作日;现已有反馈,不归为当前无反馈',[src,*['回执邮件/'+m['文件']for m in fb_mail]])
                elif unknown_mail or unresolved:add(aid,'待确认','尚有未识别或未归属邮件,不能直接认定无反馈',[src,*['回执邮件/'+m['文件']for m in unknown_mail]])
                elif cal.elapsed(iv)>cal.limits['面试反馈']:
                    add(aid,'规则超时',f'材料未见有效反馈,面试后{cal.elapsed(iv)}个工作日,超过{cal.limits["面试反馈"]};自动回复不算反馈,承接人和时间待确认',[src,*['回执邮件/'+m['文件']for m in ms]])
            else:
                scheduling=[m for m in ms if m['类型']in ['改期请求','排期确认']]
                if aid in plan or scheduling:
                    sources=[src]+([f'招聘计划.xlsx[面试排期]第{plan[aid]["line"]}行']if aid in plan else[])+['回执邮件/'+m['文件']for m in scheduling]
                    add(aid,'排期待核/待同步','系统面试时间为空;计划或邮件已有排期线索,改期请求不等于已确认,不能沿用未排期时限直接判超时',sources)
                elif cal.elapsed(enter)>cal.limits['未排期']:
                    add(aid,'规则超时',f'系统未记面试时间且本包未见排期线索,按未排期口径已{cal.elapsed(enter)}个工作日',[src])
        elif stage in ['简历筛选','用人经理复核']:
            limit=cal.limits[stage]
            if cal.elapsed(enter)>limit:add(aid,'规则超时',f'{stage}已{cal.elapsed(enter)}个工作日,超过{limit}',[src])
        elif stage=='Offer审批':
            ar=approvals.get(aid)
            if not ar:add(aid,'待确认','审批字段未提供,不能将系统阶段等同于审批实际未结束',[src]);continue
            source=[src,'审批截图/'+ar['截图文件']]
            if ar['截图状态']=='已通过':
                last=parse_date(ar['最后节点时间'])
                if last is None:raise ValueError('审批通过却缺最后节点时间:'+aid)
                due=cal.due(last,cal.limits['审批后更新'])
                if cal.stat>due:add(aid,'规则超时',f'审批已通过,系统阶段仍未同步,已过按日期计算的更新截止日{due}',source)
                elif cal.stat==due:add(aid,'截止当日待核',f'审批已通过,系统仍在审批阶段;{due}为截止当日,缺导出时刻/日内口径,不判已逾期',source)
                else:add(aid,'期限内待同步',f'审批已通过,系统仍在审批阶段,更新截止日{due}尚未到',source)
            elif cal.elapsed(enter)>cal.limits['Offer审批']:
                add(aid,'规则超时',f'审批字段仍为审批中,阶段已{cal.elapsed(enter)}个工作日,超过{cal.limits["Offer审批"]}',source)
        # 已接受是本课招聘终点;不据最后更新字段反推审批后的阶段历史。
    for key,rs in groups.items():
        if len(rs)>1:
            aid=rs[0]['申请编号'];ids='/'.join(r['申请编号']for r in rs)
            add(aid,'重复申请',f'{ids}同一完整号码代号,人数按一人;合并及主申请由HR确认',[f'{csv_name} 第'+str(r['_line'])+'行'for r in rs],key)
        if len({r['当前阶段']for r in rs})>1:add(rs[0]['申请编号'],'待确认','同一人跨多个阶段,规则没有指定主申请,不擅选第一条归属',[csv_name],key)
    for aid,item in plan.items():
        if aid not in by_id:
            ms=mails[aid];tokens={t for m in ms for t in m['号码代号']};key=next(iter(tokens))if len(tokens)==1 else'待核:'+aid
            add(aid,'系统未录',f'计划有排期{item["date"]},本次导出无该申请;核实身份后由HR补录,不并入系统人数',[f'招聘计划.xlsx[面试排期]第{item["line"]}行',*['回执邮件/'+m['文件']for m in ms]],key)
    return {'统计日':str(cal.stat),'规则来源':rules['来源'],'完成说明':'机械核对完成,不代表业务无异常或已获批准','系统原始申请数':len(rows),'系统去重后身份数':len(groups),'身份待核':unknown,'多阶段待确认':multi,'阶段人数':dict(counts),'阶段原始行数':dict(raw),'系统外申请':[a for a in plan if a not in by_id],'涉及问题身份数':len({f['候选身份']for f in findings}),'机械核对事项':findings,'未归属邮件':sorted(set(unresolved)),'邮件分类':[{'文件':m['文件'],'类型':m['类型']}for m in messages]}


def main():
    p=argparse.ArgumentParser(description=__doc__);p.add_argument('work');p.add_argument('approvals',nargs='?');p.add_argument('--rules',type=Path,default=Path(__file__).with_name('核对口径.json'));p.add_argument('--output-dir',type=Path);args=p.parse_args()
    result=analyze(args.work,args.approvals,json.loads(args.rules.read_text(encoding='utf-8')))
    if args.output_dir:
        if args.output_dir.exists():raise ValueError('输出目录已存在,请换新名称')
        args.output_dir.mkdir(parents=True)
        (args.output_dir/'核对结果.json').write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf-8')
        with(args.output_dir/'核对事项.csv').open('w',encoding='utf-8-sig',newline='')as f:
            writer=csv.DictWriter(f,fieldnames=['申请编号','候选身份','类型','事项','来源']);writer.writeheader();writer.writerows(result['机械核对事项'])
    print(json.dumps(result,ensure_ascii=False,indent=2))


if __name__=='__main__':
    try:main()
    except Exception as exc:
        print(f'核对未完成:{exc}',file=sys.stderr);sys.exit(2)
read_eml.pyscripts/read_eml.py
"""离线解码邮件全文。分类只匹配本例明确措辞,未识别项回原文核对。
python3 read_eml.py 回执邮件 --json 邮件读取.json
不指定--json时输出完整正文CSV。
"""
import argparse
import csv
import html
import json
import re
import sys
from datetime import timezone, timedelta
from email import policy
from email.parser import BytesParser
from email.utils import parsedate_to_datetime
from pathlib import Path


def classify(subject, body, auto):
    if auto: return '自动回复'
    if '反馈已录系统' in body: return '反馈已录'
    if '补发一面反馈' in body or ('反馈先发邮件' in body and '系统我先不录' in body): return '反馈未录'
    if '能否改到' in body or '想改期' in body: return '改期请求'
    if re.search(r'确认.*参加.*面', body, re.S): return '排期确认'
    if re.search(r'接受\s*offer', body, re.I): return '接受Offer'
    if '请反馈' in subject or '麻烦今天录' in body: return '催办'
    return '未识别,需核原文'


def read_messages(folder):
    records = []
    for path in sorted(Path(folder).glob('*.eml')):
        message = BytesParser(policy=policy.default).parsebytes(path.read_bytes())
        part = message.get_body(preferencelist=('plain', 'html'))
        if part is None: raise ValueError(f'邮件没有可读正文:{path.name}')
        body = part.get_content()
        if part.get_content_subtype() == 'html':
            body = re.sub(r'</?(?:p|tr|td|th|br|div)\b[^>]*>', '\n', body, flags=re.I)
            body = html.unescape(re.sub(r'<[^>]+>', '', body))
        subject = str(message.get('Subject', ''))
        timestamp = parsedate_to_datetime(message['Date'])
        if timestamp.tzinfo is None: raise ValueError(f'邮件时间缺时区:{path.name}')
        timestamp = timestamp.astimezone(timezone(timedelta(hours=8)))
        auto = bool(message.get('Auto-Submitted') and message['Auto-Submitted'] != 'no') or str(message.get('X-Autoreply', '')).lower() == 'yes' or subject.startswith(('自动回复', 'Automatic reply'))
        records.append({'文件': path.name, '发件人': str(message.get('From', '')), '时间': timestamp.isoformat(), '主题': subject, '类型': classify(subject, body, auto), '正文编号': sorted(set(re.findall(r'APP-\d{3}-\d{2}', subject+'\n'+body))), '文件名编号': sorted(set(re.findall(r'APP-\d{3}-\d{2}', path.name))), '号码代号': sorted(set(re.findall(r'\bTEL-\d+\b', body))), '正文': body})
    if not records: raise ValueError('没有找到.eml邮件')
    return records


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('folder'); parser.add_argument('--json', type=Path)
    args = parser.parse_args(); records = read_messages(args.folder)
    if args.json:
        if args.json.exists(): raise ValueError('输出已存在,请换新文件名')
        args.json.write_text(json.dumps(records, ensure_ascii=False, indent=2)+'\n', encoding='utf-8')
    else:
        writer = csv.writer(sys.stdout)
        fields = ['文件','发件人','时间','主题','类型','正文编号','文件名编号','正文']
        writer.writerow(fields)
        for record in records: writer.writerow([record[k] if not isinstance(record[k],list) else ';'.join(record[k]) for k in fields])


if __name__ == '__main__':
    try: main()
    except (ValueError,OSError,TypeError) as exc:
        print(f'邮件读取未完成:{exc}', file=sys.stderr); sys.exit(2)
identity.pyscripts/identity.py
"""只合并已确认的完整号码代号;未知身份各条保留。"""
import re


def person_key(row, line=None):
    value = (row.get('手机号') or '').strip()
    return value if re.fullmatch(r'TEL-\d+', value) else '待核:' + str(row.get('申请编号') or line)


def group_people(rows):
    groups = {}
    for line, row in enumerate(rows, 2):
        groups.setdefault(person_key(row, line), []).append(row)
    return groups


def dedupe(rows, key='手机号'):
    """兼容旧调用;跨阶段统计应使用group_people,不擅选主申请。"""
    seen, kept, duplicates, unsure = {}, [], [], []
    for row in rows:
        value = (row.get(key) or '').strip()
        if not re.fullmatch(r'TEL-\d+', value):
            unsure.append(row); kept.append(row)
        elif value in seen:
            duplicates.append((seen[value], row))
        else:
            seen[value] = row; kept.append(row)
    return kept, duplicates, unsure
核对口径.jsonscripts/核对口径.json
{
  "统计日": "2026-10-16",
  "休息日": [
    "2026-10-01",
    "2026-10-02",
    "2026-10-03",
    "2026-10-04",
    "2026-10-05",
    "2026-10-06",
    "2026-10-07"
  ],
  "调休工作日": [
    "2026-10-10"
  ],
  "时限_工作日": {
    "简历筛选": 2,
    "未排期": 3,
    "面试反馈": 2,
    "用人经理复核": 3,
    "Offer审批": 2,
    "审批后更新": 1
  },
  "来源": "招聘流程规则.pdf 第1-5条;统计日来自本次导出日。进入/面试当天不计,统计日计入;截止当日不自动判已逾期。"
}
01
本机处理自己的原件
查看可选处理方法与完整历史回放
命令(复制后在材料包根目录执行)
python3 scripts/desensitize.py 原件 我的工作目录
02
确认材料能读全
发给智能体的完整输入
这个文件夹是我这周的招聘材料。你先看看每个文件能不能读,尤其回执邮件里的 .eml 和审批截图,说一下你是直接读的还是要写脚本,各封邮件和截图讲的是什么。先别分析进度。
03
核对进度和出处
发给智能体的完整输入
按规则 PDF,统计日 10-16,把计划、系统导出和邮件/截图三方对一遍,列出卡住或漏环节的候选人,每条写清是哪个文件第几行或哪封邮件。要写脚本的话放在当前文件夹的 scratch/ 里,别写到别处。
04
05
修正判断,形成完整报告
发给智能体的续修请求
把未排期与改期待同步分开,撤回缺证据的超时、违规和“无人可录”;按新脚本重核,材料没写的留待确认。先提取审批字段另存CSV,再生成含人数、逐项出处、待确认和下一步的完整《招聘进度核对报告.md》,日志另存,原稿不动。
发给智能体的续修请求
别称人工复核,也别把未见确认写成“未定”或自定跟进日期;审批按OCR来源保留待核,摘要别称证据充分。系统外记录先核当前阶段再更新人数,别预定补入一面。合并重复的摘要、撤回和下一步,保留人数、逐项出处和待确认条件,另存完整的 招聘进度核对报告-修正版.md,既有文件保留。
发给智能体的续修请求
休假的是高远,唐宁只是紧急联系人,别用“其”混指;本轮只读OCR、未直接读PNG,别断言环境不能读图。去掉制作轮次说明和错节号,将总览、明细、待核、下一步合成一张带出处的事项表,人数表保留,正常记录简列。联系人建议不等于材料规定审批,补录后的阶段待核。通查同类问题,另存完整修正版2,前稿和日志保留。
发给智能体的续修请求
第4节与事项表重复,删掉,三图OCR核对留一处并修节号。待确认条件不全是建议:暂停需求是否继续须书面确认,联系和排期建议另写,也别把它扩大成禁止补录已有反馈。方法节只留当前采用稿、字段表和实际日志,删历版制作说明。另存完整修正版3,前稿保留。
发给智能体的续修请求
改正回复里的“排 class 类”,事项表标题去掉制作说明;候选人13已有APP/TEL身份线索,缺的是系统记录与当前阶段。把check_stages.py两处未关闭open改为with,副本放“修复脚本”并带齐同级依赖,用原审批字段重跑,结果和日志另存。生成完整修正版4,二面安排待HR决定,历史文件注明来自续修材料包;前稿与原文件都保留。
06