00
前期准备
练习材料
下载材料包| 材料 | 用途 | 文件 |
|---|---|---|
| 五份脱敏简历 | 逐项找岗位证据,核对日期与页码 | 初筛/脱敏后/ |
| 岗位说明 | 六条任职要求和英语六级加分项 | 初筛/岗位说明-数据分析专员.docx |
查看练习材料6份材料
岗位说明岗位说明-数据分析专员.docx
岗位说明:数据分析专员(零售业务部)
用人部门:零售业务部    汇报对象:数据组组长    发出:2026-10-12
任职要求
1. 统计学、数学、计算机或相关专业,本科及以上学历;
2. 3 年以上数据分析相关工作经验;
3. 熟练使用 SQL,能独立编写多表关联、窗口函数等复杂查询;
4. 会用 Python 或 R 做数据处理;
5. 有零售或电商行业数据分析经验;
6. 能独立用 Tableau 或 Power BI 制作可视化报表。
加分项
英语六级。
备注:请 HR 先做初筛,周五前把初筛记录发数据组组长,进面名单由我们定。
候选人1候选人1.pdf
扫描件,1页;原文请看PDF。
候选人2候选人2.pdf
双栏文字PDF,1页。
候选人3候选人3.pdf
文字PDF,2页;第二段经历从第1页接到第2页。
候选人4候选人4.docx
【已删】

【已删】
【已删】
【已删】
【已删】
【已删】
【已删】
身份证号
【已删】
电话
【已删】
邮箱
【已删】
教育经历
2020.09-2023.12  滨海大学  计算机技术  硕士(非全日制)
2014.09-2018.06  滨海大学  软件工程  本科
工作经历
2024年1月—至今  青禾快消品(中国)有限公司  数据分析师
负责渠道销量分析与经销商库存监控;SQL 熟练,Python 自动化日报;Tableau 搭建区域销售看板。
2022/09-2023/12  青禾快消品(中国)有限公司  数据分析实习生(在读期间,每周 3 天)
协助整理经销商数据,编写 SQL 查询。
2018.7–2022.8  滨海网络科技有限公司  Java 开发工程师
参与订单系统后端开发,写过部分报表接口(SQL)。
技能
SQL、Python、Tableau、Java;英语六级
候选人5候选人5.pdf
拍照件,1页;原文请看PDF。
01
用自己的原件时,先在本机脱敏
查看可选处理方法与完整历史回放
最早那次让智能体脱敏的完整输入(后来放弃的路线)
压缩包里是这个岗位收到的简历。先在本机把简历里的个人信息去掉:姓名、电话、邮箱、证件号、照片,文件名里的也算。处理好的放进「脱敏后」文件夹,原件别改。只在这台电脑上处理,不要上传。 不要动这个文件夹以外的文件。
那次智能体的完整回复
这是一次真实运行的原样回复,后来这条路被放弃。长内容可在框内滚动,或切到原始文本查看。
完成。5 份简历已全部脱敏,放在 脱敏后/ 文件夹,全程只在本机处理,未上传任何内容;原压缩包校验和前后一致,未做任何改动。
产出文件(编号按压缩包内顺序:1=苏明远、2=林蔚然、3=郜子涵、4=何佳琪、5=赵一鸣,未在文件夹里留对应关系表):
候选人1_脱敏.pdf— 删除页眉(含姓名)、姓名行、电话/邮箱行候选人2_脱敏.pdf— 删除姓名、电话、邮箱;消除文字后用底色填充,版面无涂改痕迹候选人3_脱敏.pdf— 扫描件,整页是图片,在像素层面抹白姓名/电话/邮箱三行,并替换掉原图数据(不是简单盖黑框,旧图已从文件中彻底移除,经哈希比对确认)候选人4_脱敏.pdf— 同上;这页有棕色相纸边框,第一次处理时边框被误判为文字行,已修正,边框完好候选人5_脱敏.docx— 清除正文姓名、页眉里的姓名+手机号、表格里的身份证号/电话/邮箱(字段标签保留、值清空),并删除了文档缩略图
同时清掉了所有 PDF 的标题/作者/XMP 元数据(其中两份扫描件的 PDF 标题原本就带姓名和手机号)和 docx 缩略图。处理后做了四重验证:文本重新提取、docx 全包字节级扫描、每页渲染目检(含 300dpi 放大确认无文字残影)、证件号/手机号/邮箱正则全查——均无残留。
两点说明:
- 没有任何真人照片:林蔚然 PDF 和赵一鸣 docx 里的图片只是灰色“照片”占位框,不含个人信息,已保留。其余简历也无证件照。
- 只删了指定的五类(姓名、电话、邮箱、证件号、照片)。居住地(上海·浦东、杭州)、性别、出生年月、婚姻状况、学校与公司名称仍在正文里。如果这些也要去掉,告诉我一声即可补做。
命令(复制后在上级目录执行)
python3 脱敏.py 原件 试跑 敏感词.txt
脱敏.py 第一次运行的实际输出
本次输出 3 份(共 5 份原件,2 份未输出),在 试跑;对照表在 /workspace/iso-hr-resume-evidence-review/agent-v3/runs/demo-desensitize
对照表的「本次状态」一列写明每个人这次有没有输出;编号固定,未输出的人也留在表里。
【数据分析专员】何佳琪_13719026658.pdf 第1页没有文字层,未处理。看 /workspace/iso-hr-resume-evidence-review/agent-v3/runs/demo-desensitize/格子图/【数据分析专员】何佳琪_13719026658.pdf-第1页.png 的刻度,在 遮盖.txt 里写要抹的范围后重跑;这份文件这次不输出
【数据分析专员】郜子涵_18604513372.pdf 第1页没有文字层,未处理。看 /workspace/iso-hr-resume-evidence-review/agent-v3/runs/demo-desensitize/格子图/【数据分析专员】郜子涵_18604513372.pdf-第1页.png 的刻度,在 遮盖.txt 里写要抹的范围后重跑;这份文件这次不输出
待确认 2 条(页眉区删除、含字段词但保留的文字),写在 /workspace/iso-hr-resume-evidence-review/agent-v3/runs/demo-desensitize/脱敏待确认-不要放进给AI的文件夹.txt,请逐条看
下一步:用 查漏.py 检查输出文件夹,再打开每份文件看一遍。
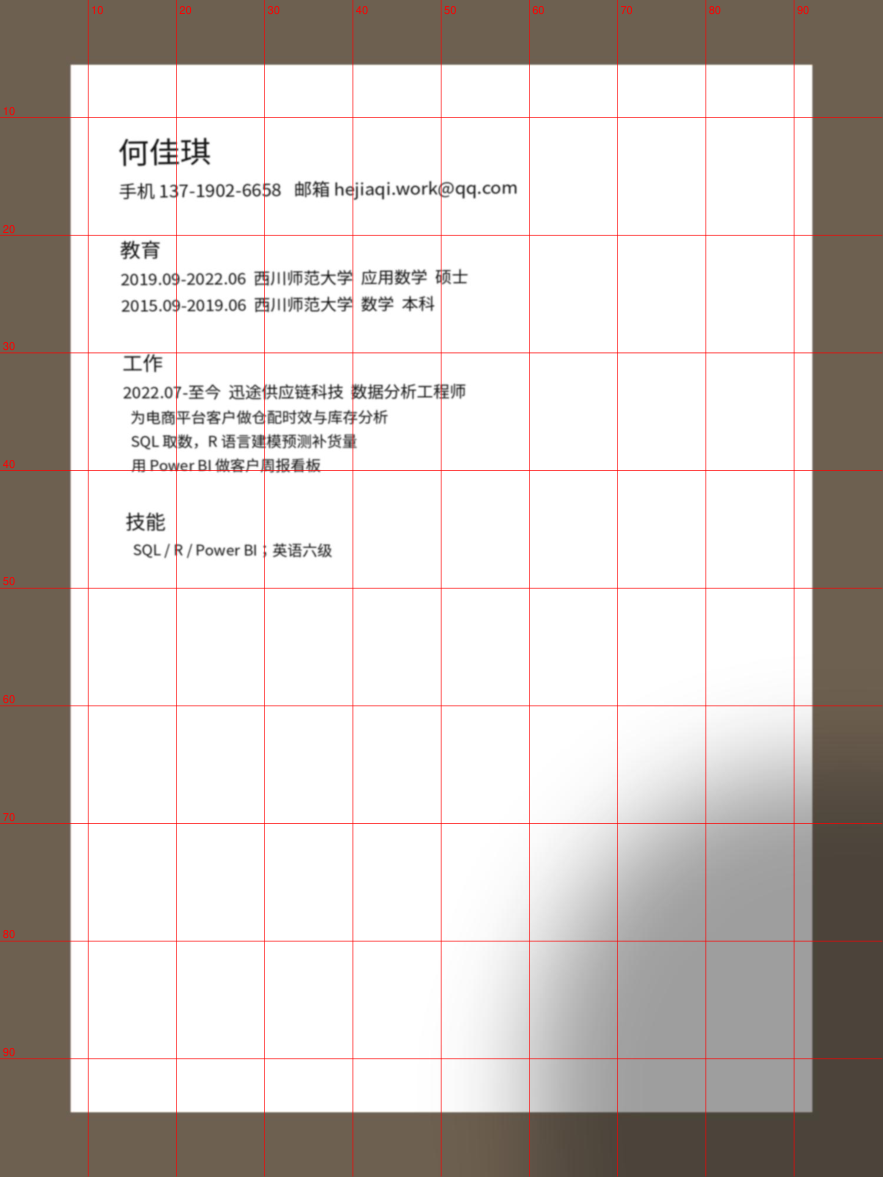
本例的遮盖.txt(每行:文件名 页码 左 上 右 下,单位是页面宽高的百分比)
【数据分析专员】何佳琪_13719026658.pdf 1 12 10 62 18.5
【数据分析专员】郜子涵_18604513372.pdf 1 5 11 45 22
命令(复制后在上级目录执行)
python3 脱敏.py 原件 初筛/脱敏后 敏感词.txt 遮盖.txt
脱敏.py 第二次运行的实际输出
本次输出 5 份(共 5 份原件,0 份未输出),在 初筛/脱敏后;对照表在 /workspace/iso-hr-resume-evidence-review/agent-v3/runs/demo-desensitize
对照表的「本次状态」一列写明每个人这次有没有输出;编号固定,未输出的人也留在表里。
没有待人工处理的页
待确认 2 条(页眉区删除、含字段词但保留的文字),写在 /workspace/iso-hr-resume-evidence-review/agent-v3/runs/demo-desensitize/脱敏待确认-不要放进给AI的文件夹.txt,请逐条看
下一步:用 查漏.py 检查输出文件夹,再打开每份文件看一遍。
命令(复制后在上级目录执行)
python3 查漏.py 初筛/脱敏后 敏感词.txt
查漏.py 的实际输出
== 命中(必须处理)==
无
== 需要人眼看的地方 ==
候选人1.pdf 第1页没有文字层(扫描或拍照),已存图到旁边的 查漏截图/ 文件夹,请打开逐行看
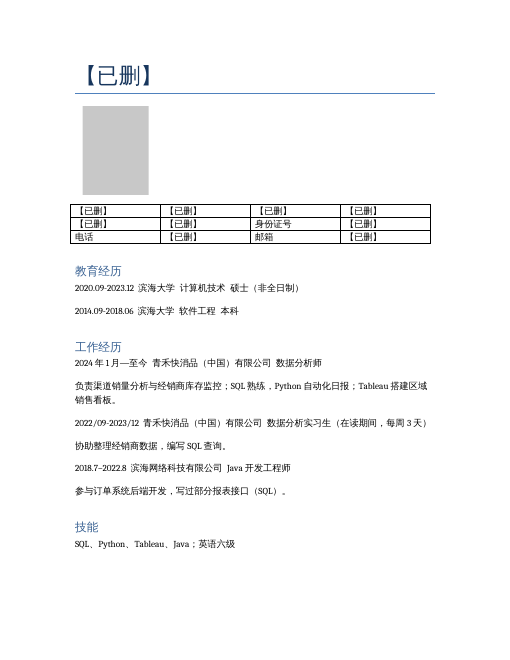
候选人4.docx 里的 word/media/image1.png
候选人5.pdf 第1页没有文字层(扫描或拍照),已存图到旁边的 查漏截图/ 文件夹,请打开逐行看
命令(复制后在上级目录执行)
python3 逐段对比.py 原件 初筛/脱敏后 对照表-不要放进给AI的文件夹.csv 敏感词.txt > 对比结果.txt
逐段对比.py 的实际输出
===== 候选人1.pdf  ←  【数据分析专员】何佳琪_13719026658.pdf
  原件没有文字层(扫描或拍照),这个脚本比不了,请打开原件和脱敏后的图逐行看

===== 候选人2.pdf  ←  【数据分析专员】林蔚然_15966310827.pdf
  [✓ 只删了个人信息]
    原 第1页:林蔚然
    原 第1页:电话 159 6631 0827 项目经历
    原 第1页:lin.weiran@outlook.com 毕业论文:社交电商用户复购影响因素
    后 第1页:电话 项目经历
    后 第1页:毕业论文:社交电商用户复购影响因素
  小结:改动 1 处,其中 ⚠ 0 处

===== 候选人3.pdf  ←  【数据分析专员】苏明远_13822074519.pdf
  [⚠ 请看:除个人信息外还有字不一样]
    原 第1页:聘达通·简历导出 苏明远-简历
    原 第1页:苏明远
    原 第1页:电话:138-2207-4519 邮箱:suminyuan2019@163.com
    后 第1页:电话: 邮箱:
  [⚠ 请看:除个人信息外还有字不一样]
    原 第2页:聘达通·简历导出 苏明远-简历
    后:(整行没了)
  小结:改动 2 处,其中 ⚠ 2 处

===== 候选人4.docx  ←  【数据分析专员】赵一鸣_13910285573.docx
  [✓ 只删了个人信息]
    原 document:赵一鸣
    原 document:性别 | 男 | 出生年月 | 1996.05
    原 document:婚姻状况 | 已婚 | 身份证号 | 330106199605120036
    原 document:电话 | 139-1028-5573 | 邮箱 | zhaoyiming96@gmail.com
    后 document:【已删】
    后 document:【已删】 | 【已删】 | 【已删】 | 【已删】
    后 document:【已删】 | 【已删】 | 身份证号 | 【已删】
    后 document:电话 | 【已删】 | 邮箱 | 【已删】
  [⚠ 请看:除个人信息外还有字不一样]
    原 header1:赵一鸣 个人简历 13910285573
    后:(整行没了)
  小结:改动 2 处,其中 ⚠ 1 处

===== 候选人5.pdf  ←  【数据分析专员】郜子涵_18604513372.pdf
  原件没有文字层(扫描或拍照),这个脚本比不了,请打开原件和脱敏后的图逐行看

共 ⚠ 3 处。每处 ⚠ 都要打开原件看:删掉的是不是个人信息;是工作内容就改规则或手动补回。
02
逐条找证据
发给智能体的完整输入
对照岗位说明,把「脱敏后」里的每份简历按任职要求逐条过一遍:每条有没有证据,写明是哪个文件第几页、原文怎么写的;简历里没写的标「没写」。不打分、不排名,结果存成 初筛记录.md。 不要动这个文件夹以外的文件。
03
另开会话核对
发给智能体的完整输入
帮我检查 初筛记录.md:每条引用回原文核对,页码对不对;每个人的工作年限写个小脚本重算,把算式列出来;再看有没有把「没写」当成不满足、只在技能栏出现就算有经验的地方。问题写进 核对.md,先别改初筛记录。 不要动这个文件夹以外的文件。
04
明确决定,再让它改
发给智能体的完整输入
按 核对.md 改初筛记录,另存为 初筛记录-修订.md。有两点我定了:候选人2在咨询公司的实习是资料整理和问卷录入,不算数据分析经验;年限统一按 核对.md 里的口径算。 不要动这个文件夹以外的文件。
05
统一口径,生成完整终稿
发给智能体的续修请求
继续核对这份修订稿。年限统一按2026年10月、起止月都计入、重叠去重、实习单列;候选人2的咨询实习不计相关经验,候选人4的Java和实习相关性待定。回原简历核SQL/Python、看板制作和行业证据,把证据、年限、待确认问题合成完整新稿,另存为 初筛记录-统一口径.md,前稿保留。
发给智能体的续修请求
再改几处:候选人1的行业是否符合仍待招聘方确认,补进待确认表;补齐候选人2的SQL/Python和看板制作、候选人5的Python/R追问。候选人4全职与实习始终分列,Java计入时单算全职,别合成100个月。核验说明只写本轮实际做过的事,别把旧核对稿当人工视觉核验。保持10月含当月,不列其他口径,精简重复说明,另存完整修正版。
发给智能体的续修请求
分开列实习,不等于全职不能累计。候选人4的Java若认定相关,应与现有相关全职去重累计,并列出月数;实习仍单列待定。删掉“各段单独对照36个月、不与其他段合并”的新规则,通查同类说法。终稿删掉版本改动清单,压缩重复说明,保留逐项证据和计算方法,另存完整终稿。
发给智能体的续修请求
终稿的年限表漏了候选人5。请补回这行及算式,逐人检查五份简历的七项要求、年限、出处和待确认项都齐全;保留统一口径与既有待定条件,核对后另存为 初筛记录-终稿2.md,前稿保留。
06